Pular para o conteúdo principal

ER2020 - 1st Workshop on Conceptual Modeling for NoSQL Data Stores

 Site do Workshop

https://sites.google.com/view/comonos20/home

Artigos aceitos

Pablo D. Muñoz-Sánchez, Carlos Javier Fernández Candel, Jesús García-Molina and Diego Sevilla Ruiz. Extracting Physical and Logical Schemas for Document Stores. 

Pavel Čontoš and Martin Svoboda. JSON Schema Inference Approaches. 

Alberto Hernández Chillón, Diego Sevilla Ruiz and Jesus Garcia-Molina. Deimos: A Model-based NoSQL Data Generation Language.

Dois sobre engenharia reversa aplicados a Document Stores

Invited Talk

Pascal Desmarets (Hackolade): NoSQL Data Modelling in Practice

Vídeo -> https://drive.google.com/file/d/1Sps7qS4yfG-KEXaDdYuopDP-SzMqP1QN/view

Apresentação -> https://drive.google.com/file/d/1mOc_Zv_u9i4d84cJHvSGW56V-OQ_rACg/view 


Considerações: 

Agile x Data Modeling as a bottleneck.

Low ROI of Big Data projects

The tree phases of traditional Data Modeling should be redesigned to two: Domain-Driven Design (technology agnostic) + Physical Schema Design (application-specific) **
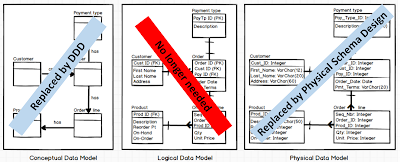
Image for post

Aggregation is the opposite of Normalization and reduces (eliminates!) impedance mismatch of data (physical schema) and objects (application)

Schemaless is misinterpreted and flexibility is not easy to deal. How to process empty, missing or null attributes? How to express relationships: referencing ou embedding? How to use polymorphic data types and check its quality? 

Reverse-Engineering whithout DDL: probabilistic schema inference, required x optional, polymorphism, pattern detection, relationships

Schema inference meta model (slide 48)

The term schema-on-read is not accurated since the time you store data there is a schema. 

Graph should be divided into LPG and RDF

Obs1. o apresentador escreveu outro artigo: Data Modeling Is Dead…Long Live Schema Design!

  • https://medium.com/hackolade/data-modeling-is-dead-long-live-schema-design-4c1aed88cc21
  • https://www.datastax.com/resources/video/datastax-accelerate-2019-data-modeling-dead-long-live-schema-design

Some quotes from these articles


** Logical modeling makes sense when aiming to achieve an application-agnostic database design, which is still best served by relational database technology.

DDD consists of a collection of patterns, principles, and practices that enable teams to focus on what’s core to the success of the business while crafting software that tackles the complexity in both the business and the technical spaces. One such pattern is an aggregate, a cluster of domain objects that can be treated as a single unit, for example an order and its order lines


Obs2. e representa uma empresa que desenvolveu uma ferramenta de modelagem NoSQL (polymorphic data modeling) e tem treinamentos nessa área.

  • https://hackolade.com/
  • https://hackolade.com/training.html


Comentários

Postagens mais visitadas deste blog

Aprendizado de Máquina Relacional

 Extraído de -> https://www.lncc.br/~ziviani/papers/Texto-MC1-SBBD2019.pdf   Aprendizado de máquina relacional (AMR) destina-se à criação de modelos estatísticos para dados relacionais (seria o mesmo que dados conectados) , isto é, dados cuja a informação relacional é tão ou mais impor tante que a informação individual (atributos) de cada elemento.    Essa classe de aprendizado tem sido utilizada em diversas aplicações, por exemplo, na extração de informação de dados não estruturados [Zhang et al. 2016] e na modelagem de linguagem natural [Vu et al. 2018].   A adoção de técnicas de aprendizado de máquina relacional em tarefas de comple mentação de grafo de conhecimento se baseia na premissa de existência de regularidades semânticas presentes no mesmo . Modelos grafos probabilísticos  Baseada em regras / heurísticas que não podem garantir 100% de precisão no resultado da inferência mas os resultados podem ser explicados. Modelos de características de ...

Defesa de Doutorado de Grettel Monteagudo Garcia

A última atividade presencial que fiz na PUC-Rio foi assistir a defesa de tese da Grettel Monteagudo Garcia , em 13/03/2020 (uma sexta-feira 13 !!!!). O título da tese é “ A Keyword-based Query Processing Method for Datasets with Schemas ” e me interessou por causa do projeto do NIMA. A proposta parte do cenário onde usuários possam consultar dados, armazenados em bancos de dados relacionais e TripleStores, de maneira semelhante ao Google, ou seja, digitando palavras-chave, e deixando para o sistema recuperar os dados que melhor correspondem ao conjunto de palavras-chave.  Na tese estão descritos um algoritmo e um framework projetados para processar consultas baseadas em palavras-chave para bases de dados com esquema, especificamente bancos relacionais e bases de dados em RDF. A primeira etapa do algoritmo é a conversão do conjunto de palavras chaves em uma consulta abstrata explorando um esquema abstrato . Nesta etapa o principal desafio é achar onde a informação está (os matches...

Metodologia Científica II - continuação

No primeiro post  foram detalhados os 6 primeiros vídeos do canal do Youtube do professor Eduardo Ogasawara do CEFET/RJ   Mais 3 vídeos foram disponibilizados e estão comentados a seguir: Gráficos, Figuras e Tabelas (33 minutos) - como apresentar os resultados das avaliações experimentais. Gráficos: associar análises dos resultados a cada gráfico apresentado, problemas comuns na montagem de gráficos (não usar todo eixo X ou Y, não usar área útil com uma escala adequada a ver o comportamento dos números, não marcar os pontos de observação da série, inconsistência no uso de cores ), escala logarítmica x linear, eixo X para a variável independente e Y para a dependente (resposta), escrever boas legendas para os gráficos, observar se diferenças entre variáveis apresentadas em gráficos separados podem atrapalhar a interpretação dos resultados. Diagramas devem ser pensados de acordo com o propósito, trata-se de uma abstração e cada elemento deve ser explicado no texto, rótulos...