Pular para o conteúdo principal

human in the loop - HITL


O Human-in-the-loop (HITL) é um ramo da inteligência artificial que aproveita a inteligência humana e de máquina para criar modelos de aprendizado de máquina. Em uma abordagem tradicional do HITL, as pessoas estão envolvidas em um círculo virtuoso, onde treinam, sintonizam e testam um algoritmo específico.


Geralmente, funciona assim:

Primeiro, os seres humanos rotulam dados. Isso fornece ao modelo uma alta qualidade e quantidade de dados de treinamento. Um algoritmo de aprendizado de máquina aprende a tomar decisões com base nesses dados.

Em seguida, os seres humanos ajustam o modelo. Isso pode acontecer de várias maneiras diferentes, mas geralmente os humanos atribuem uma pontuação aos dados para indicar excesso de ajuste (overfitting), para ensinar um classificador sobre casos extremos (outlier) ou novas categorias no âmbito do modelo.

Por fim, as pessoas podem testar e validar um modelo atribuindo uma pontuação ao resultado, especialmente em casos onde um algoritmo não tem confiança em um classificação ou confia demais em uma decisão incorreta.

Agora, é importante observar que cada uma dessas ações compreende um loop de feedback contínuo. O aprendizado de máquina HITL significa pegar cada uma dessas tarefas de treinamento, ajuste e teste e alimentá-las de volta no algoritmo para que fique mais inteligente, mais confiante e mais preciso. Isso pode ser especialmente eficaz quando o modelo seleciona o que ele precisa aprender a seguir - conhecido como aprendizado ativo - e você envia esses dados aos anotadores humanos para treinamento.
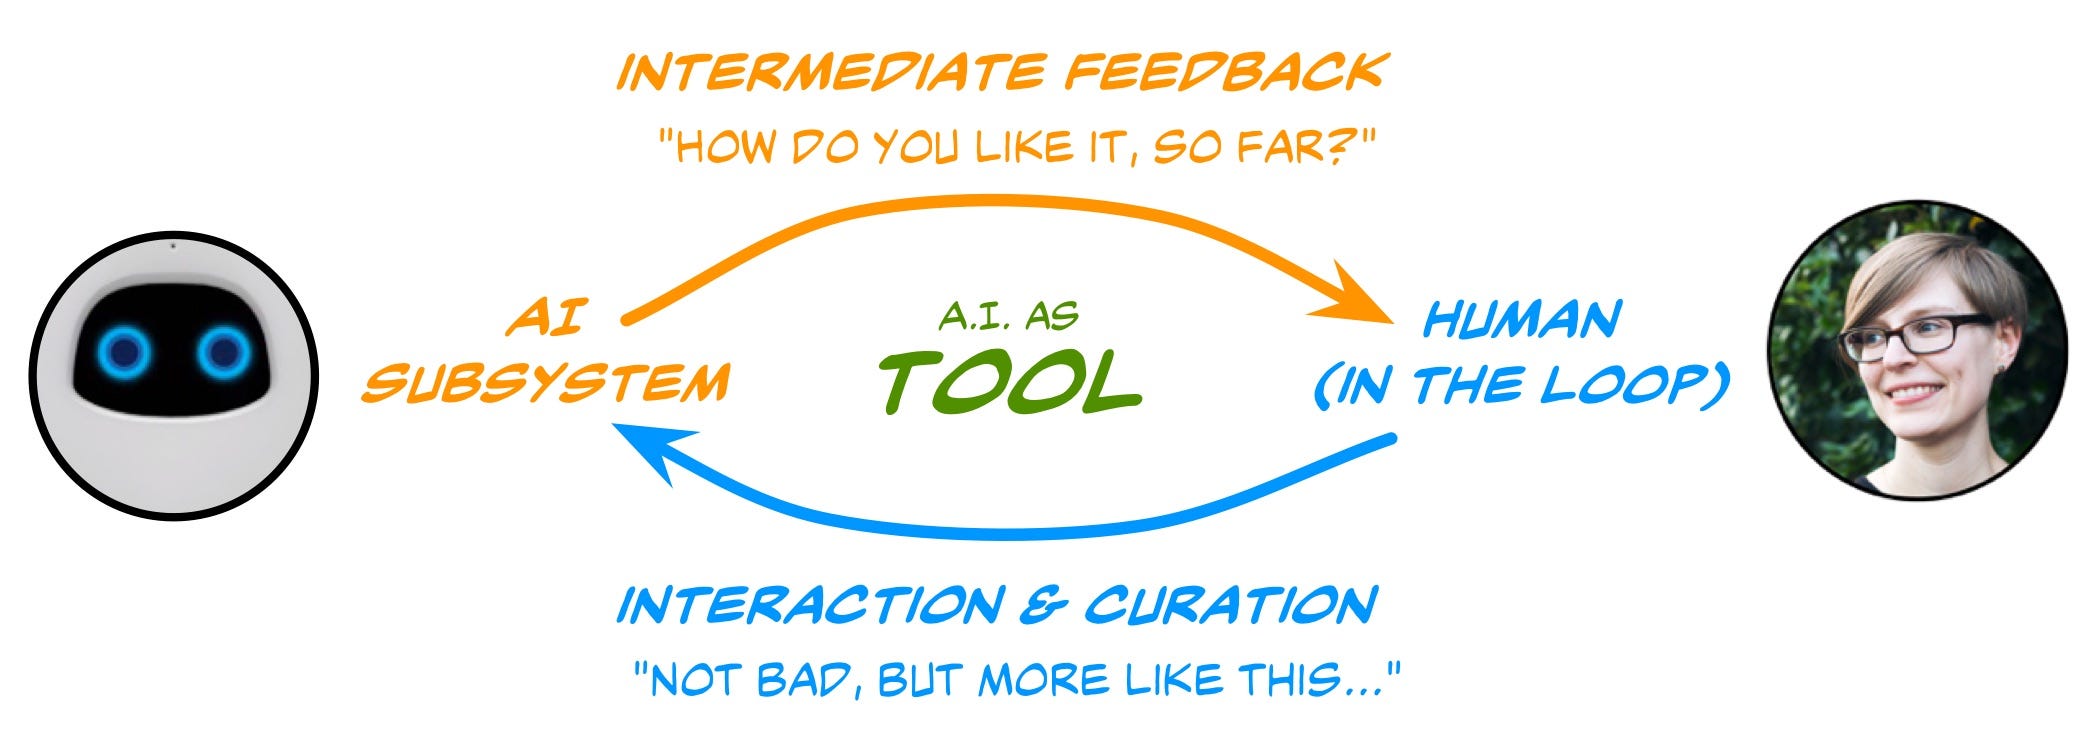


HITL on Amazon AWS - https://youtu.be/rJw7u8qyDf4

Dicionario de Crowdsourcing - https://www.clickworker.com/crowdsourcing-glossary/human-in-the-loop/

Comentários

Postagens mais visitadas deste blog

Aprendizado de Máquina Relacional

 Extraído de -> https://www.lncc.br/~ziviani/papers/Texto-MC1-SBBD2019.pdf   Aprendizado de máquina relacional (AMR) destina-se à criação de modelos estatísticos para dados relacionais (seria o mesmo que dados conectados) , isto é, dados cuja a informação relacional é tão ou mais impor tante que a informação individual (atributos) de cada elemento.    Essa classe de aprendizado tem sido utilizada em diversas aplicações, por exemplo, na extração de informação de dados não estruturados [Zhang et al. 2016] e na modelagem de linguagem natural [Vu et al. 2018].   A adoção de técnicas de aprendizado de máquina relacional em tarefas de comple mentação de grafo de conhecimento se baseia na premissa de existência de regularidades semânticas presentes no mesmo . Modelos grafos probabilísticos  Baseada em regras / heurísticas que não podem garantir 100% de precisão no resultado da inferência mas os resultados podem ser explicados. Modelos de características de ...

Defesa de Doutorado de Grettel Monteagudo Garcia

A última atividade presencial que fiz na PUC-Rio foi assistir a defesa de tese da Grettel Monteagudo Garcia , em 13/03/2020 (uma sexta-feira 13 !!!!). O título da tese é “ A Keyword-based Query Processing Method for Datasets with Schemas ” e me interessou por causa do projeto do NIMA. A proposta parte do cenário onde usuários possam consultar dados, armazenados em bancos de dados relacionais e TripleStores, de maneira semelhante ao Google, ou seja, digitando palavras-chave, e deixando para o sistema recuperar os dados que melhor correspondem ao conjunto de palavras-chave.  Na tese estão descritos um algoritmo e um framework projetados para processar consultas baseadas em palavras-chave para bases de dados com esquema, especificamente bancos relacionais e bases de dados em RDF. A primeira etapa do algoritmo é a conversão do conjunto de palavras chaves em uma consulta abstrata explorando um esquema abstrato . Nesta etapa o principal desafio é achar onde a informação está (os matches...

Metodologia Científica II - continuação

No primeiro post  foram detalhados os 6 primeiros vídeos do canal do Youtube do professor Eduardo Ogasawara do CEFET/RJ   Mais 3 vídeos foram disponibilizados e estão comentados a seguir: Gráficos, Figuras e Tabelas (33 minutos) - como apresentar os resultados das avaliações experimentais. Gráficos: associar análises dos resultados a cada gráfico apresentado, problemas comuns na montagem de gráficos (não usar todo eixo X ou Y, não usar área útil com uma escala adequada a ver o comportamento dos números, não marcar os pontos de observação da série, inconsistência no uso de cores ), escala logarítmica x linear, eixo X para a variável independente e Y para a dependente (resposta), escrever boas legendas para os gráficos, observar se diferenças entre variáveis apresentadas em gráficos separados podem atrapalhar a interpretação dos resultados. Diagramas devem ser pensados de acordo com o propósito, trata-se de uma abstração e cada elemento deve ser explicado no texto, rótulos...